AI 멀티 에이전트 오케스트레이션으로 ESG/IFRS 지속가능경영보고서를 자동 생성하고, ISO 14064-1 기반 온실가스 배출량을 계산하는 엔터프라이즈급 통합 플랫폼입니다.
- 기간
- 2025.10 ~ 2026.04 (6개월)
- 팀 구성
- 2인
- 담당 역할
- AI 멀티 에이전트 · 백엔드 · 인프라 전담
프로젝트 소개
ESG 공시 의무화 흐름 속에서, 보고서 작성에 수십 시간이 걸리는 수작업을 AI로 대체하는 것이 목표였습니다.
지속가능경영보고서(SR)는 IFRS S1/S2, GRI, ESRS 등 여러 기준의 수백 개 데이터포인트를 다뤄야 하고, 온실가스 배출량 계산·근거 데이터 수집까지 필요해 전문가도 수십 시간이 걸리는 작업입니다. IFRSseed는 웹 크롤링부터 데이터 추출, 문단 생성, 검증까지의 전 과정을 End-to-End로 자동화해 이 작업을 1시간 수준으로 줄였습니다.
완전 자동화
웹 크롤링 → 데이터 추출 → 보고서 생성까지 End-to-End 자동화
AI 멀티 에이전트
LangGraph 기반 5개 전문 에이전트 협업 워크플로우
크로스 스탠다드 매핑
AI가 IFRS · GRI · ESRS 간 데이터포인트를 자동 매핑
실시간 검증
LLM 규칙 검증 + 이상치 탐지 + 데이터 품질 관리
주요 기능
플랫폼은 4개의 핵심 플로우로 구성됩니다. 각 플로우는 독립적인 도메인 모듈(Hub & Spokes)로 구현했습니다.
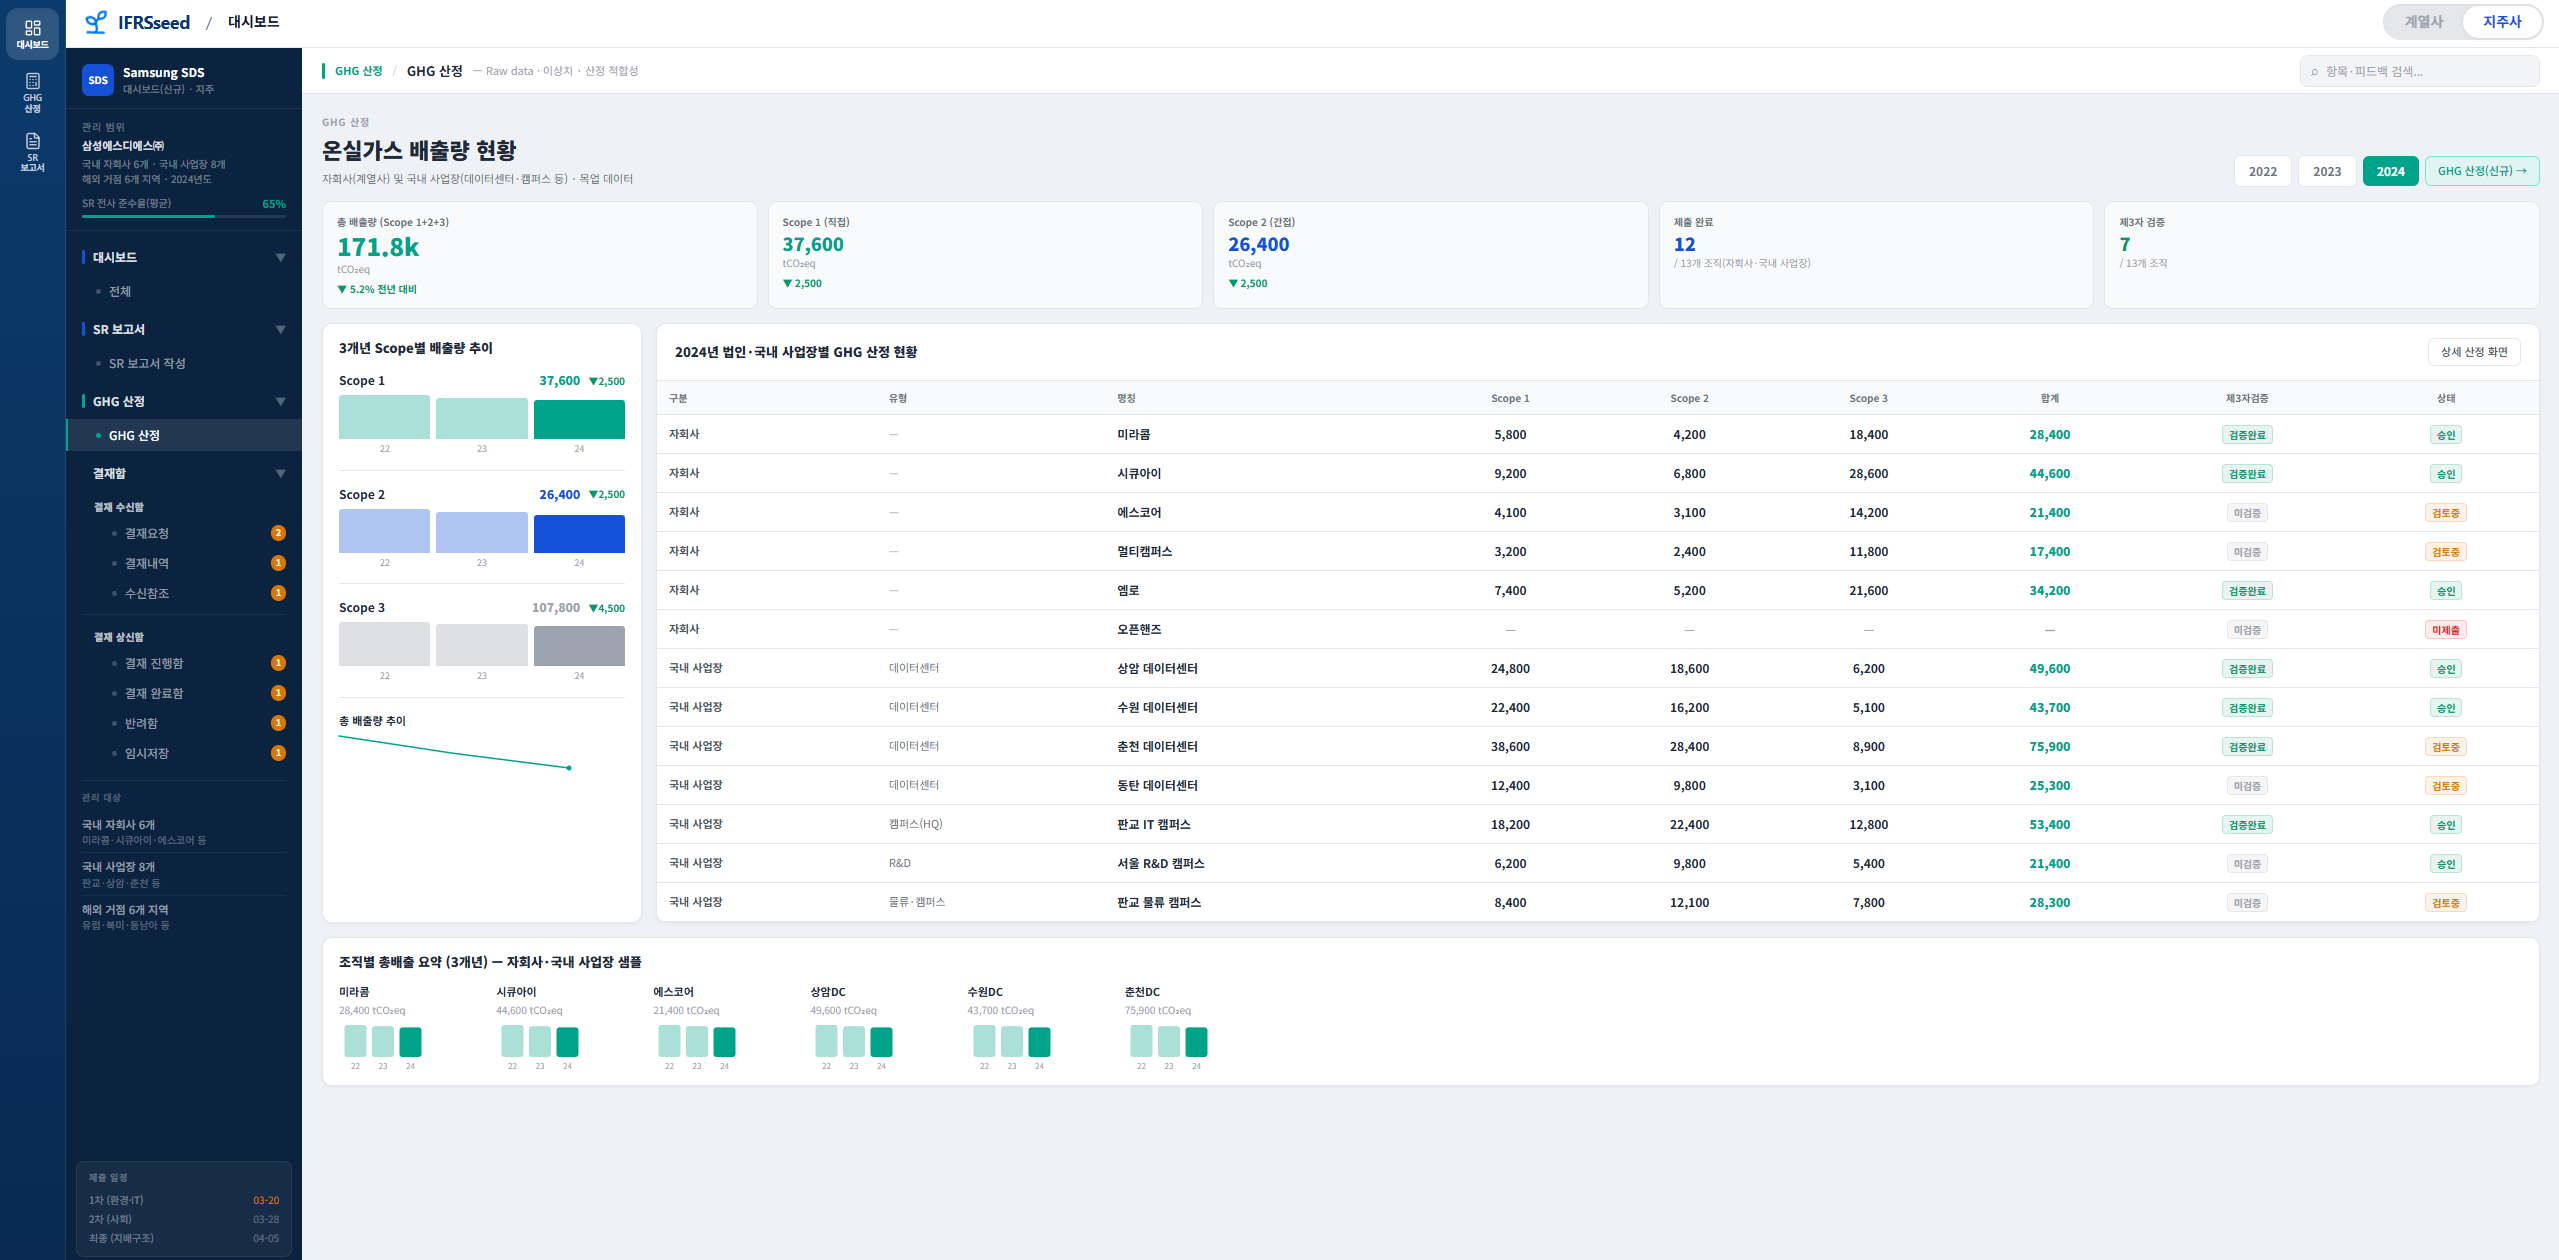
SR 보고서 자동 생성 (IFRS Agent)
"삼성SDS 2024년 보고서 생성" 같은 자연어 요청 하나로 지속가능경영보고서 초안을 만들어냅니다. LangGraph 기반 Phase 0~4 워크플로우가 프롬프트 해석 → 데이터포인트(DP) 선택 → 데이터 수집 → 문단 생성 → 검증을 순차 수행하고, 진행 상황은 SSE로 실시간 스트리밍됩니다.
GHG 배출량 계산 (ISO 14064-1)
Excel/CSV 원시 데이터를 업로드하면 컬럼 매핑·단위 정규화(kWh→TJ 등 20+ 단위) → 통계 기반 이상치 탐지(z-score, IQR) → 배출계수 매핑 → Scope 1/2/3 배출량 계산까지 자동으로 처리합니다. GWP(AR5/AR6) 기준을 지원하며 1,000행 기준 3초 만에 계산이 끝납니다.
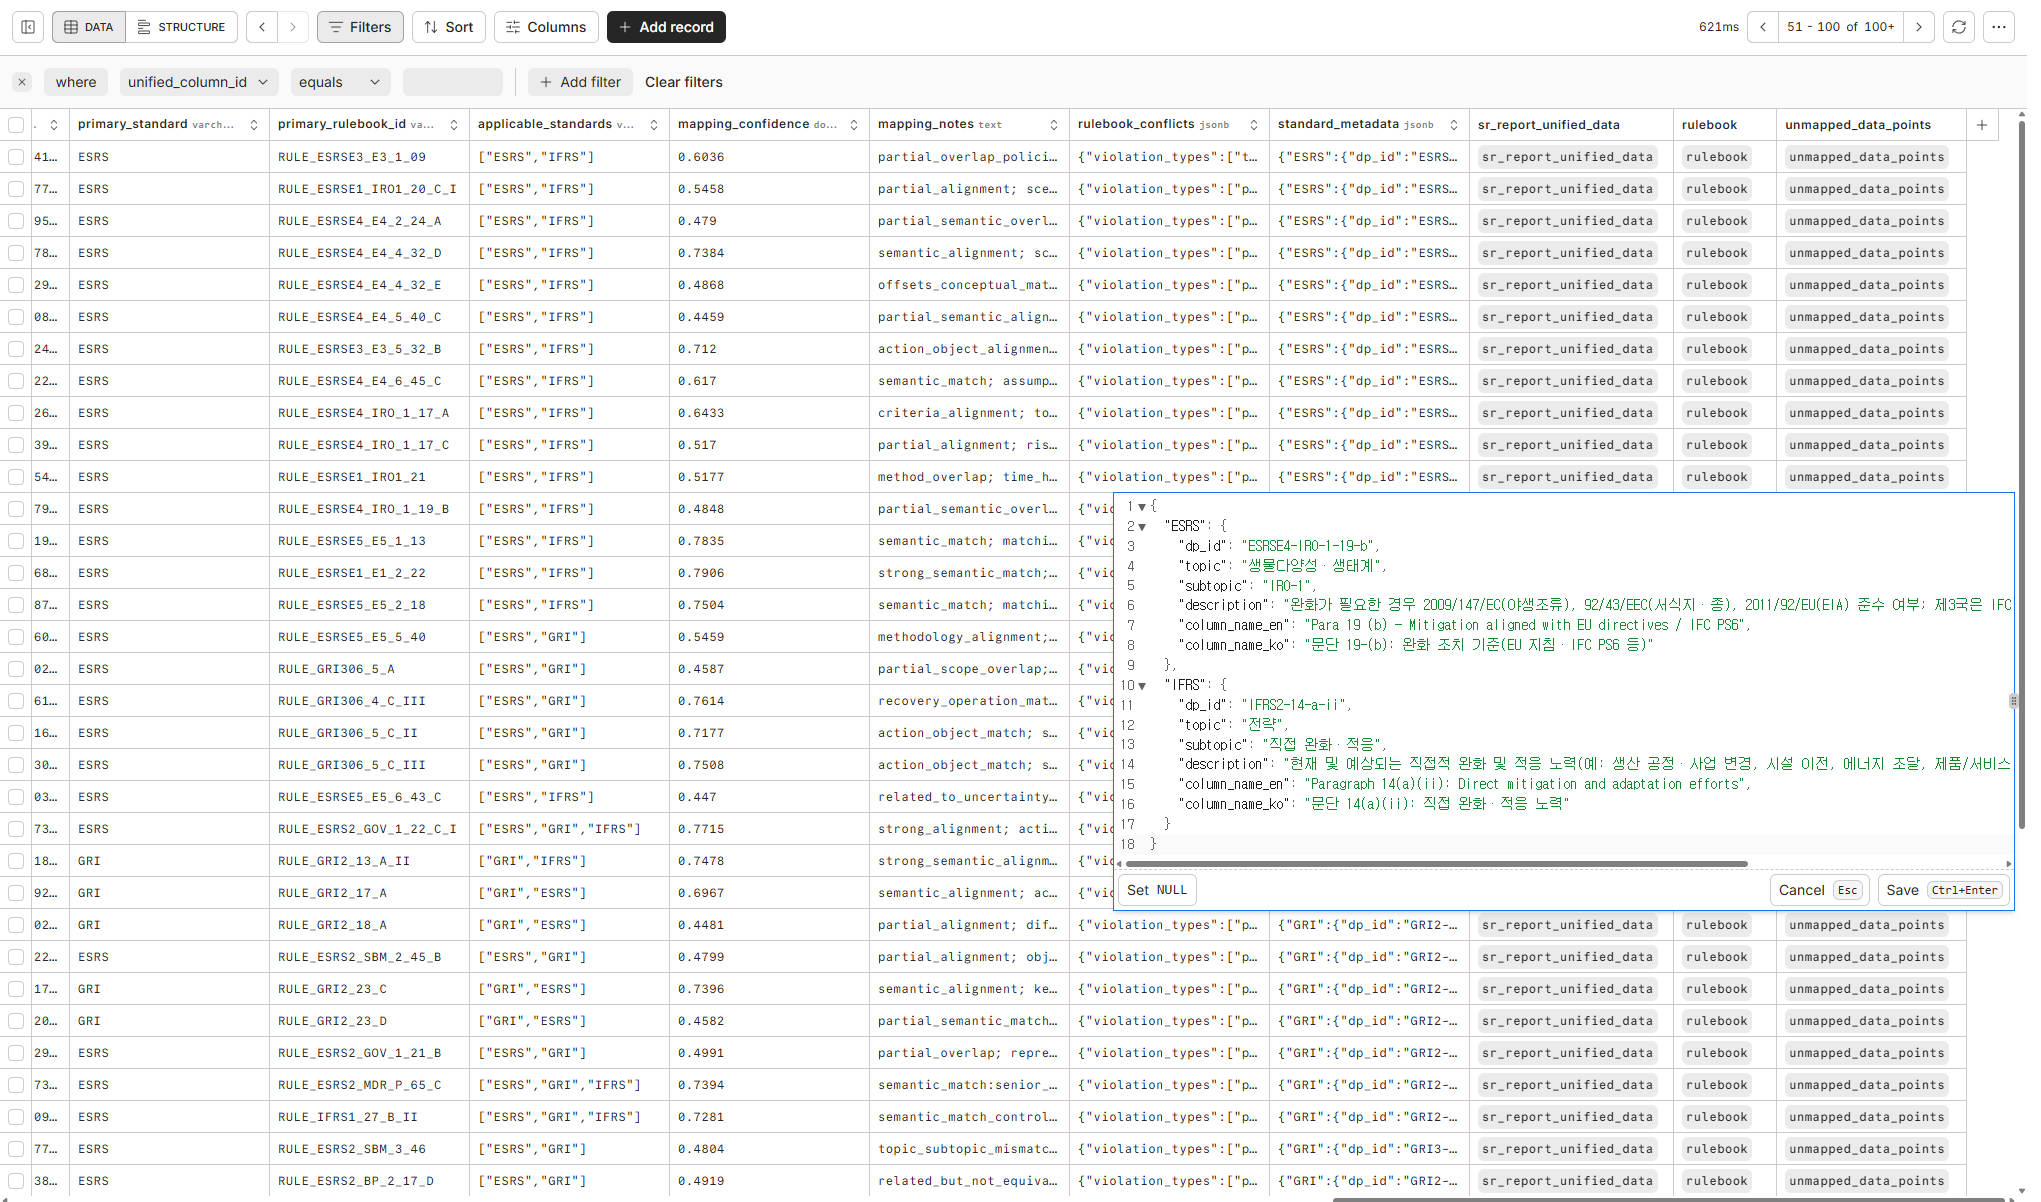
크로스 스탠다드 UCM 자동 매핑
IFRS · GRI · ESRS 등 서로 다른 공시 기준의 데이터포인트를 AI가 자동으로 연결합니다. pgvector 코사인 유사도 검색 → 정책 기반 필터링 → 경계 구간(0.35~0.75)만 LLM이 재판정하는 3단계 하이브리드 전략으로, 비용을 아끼면서 정확도를 끌어올렸습니다.
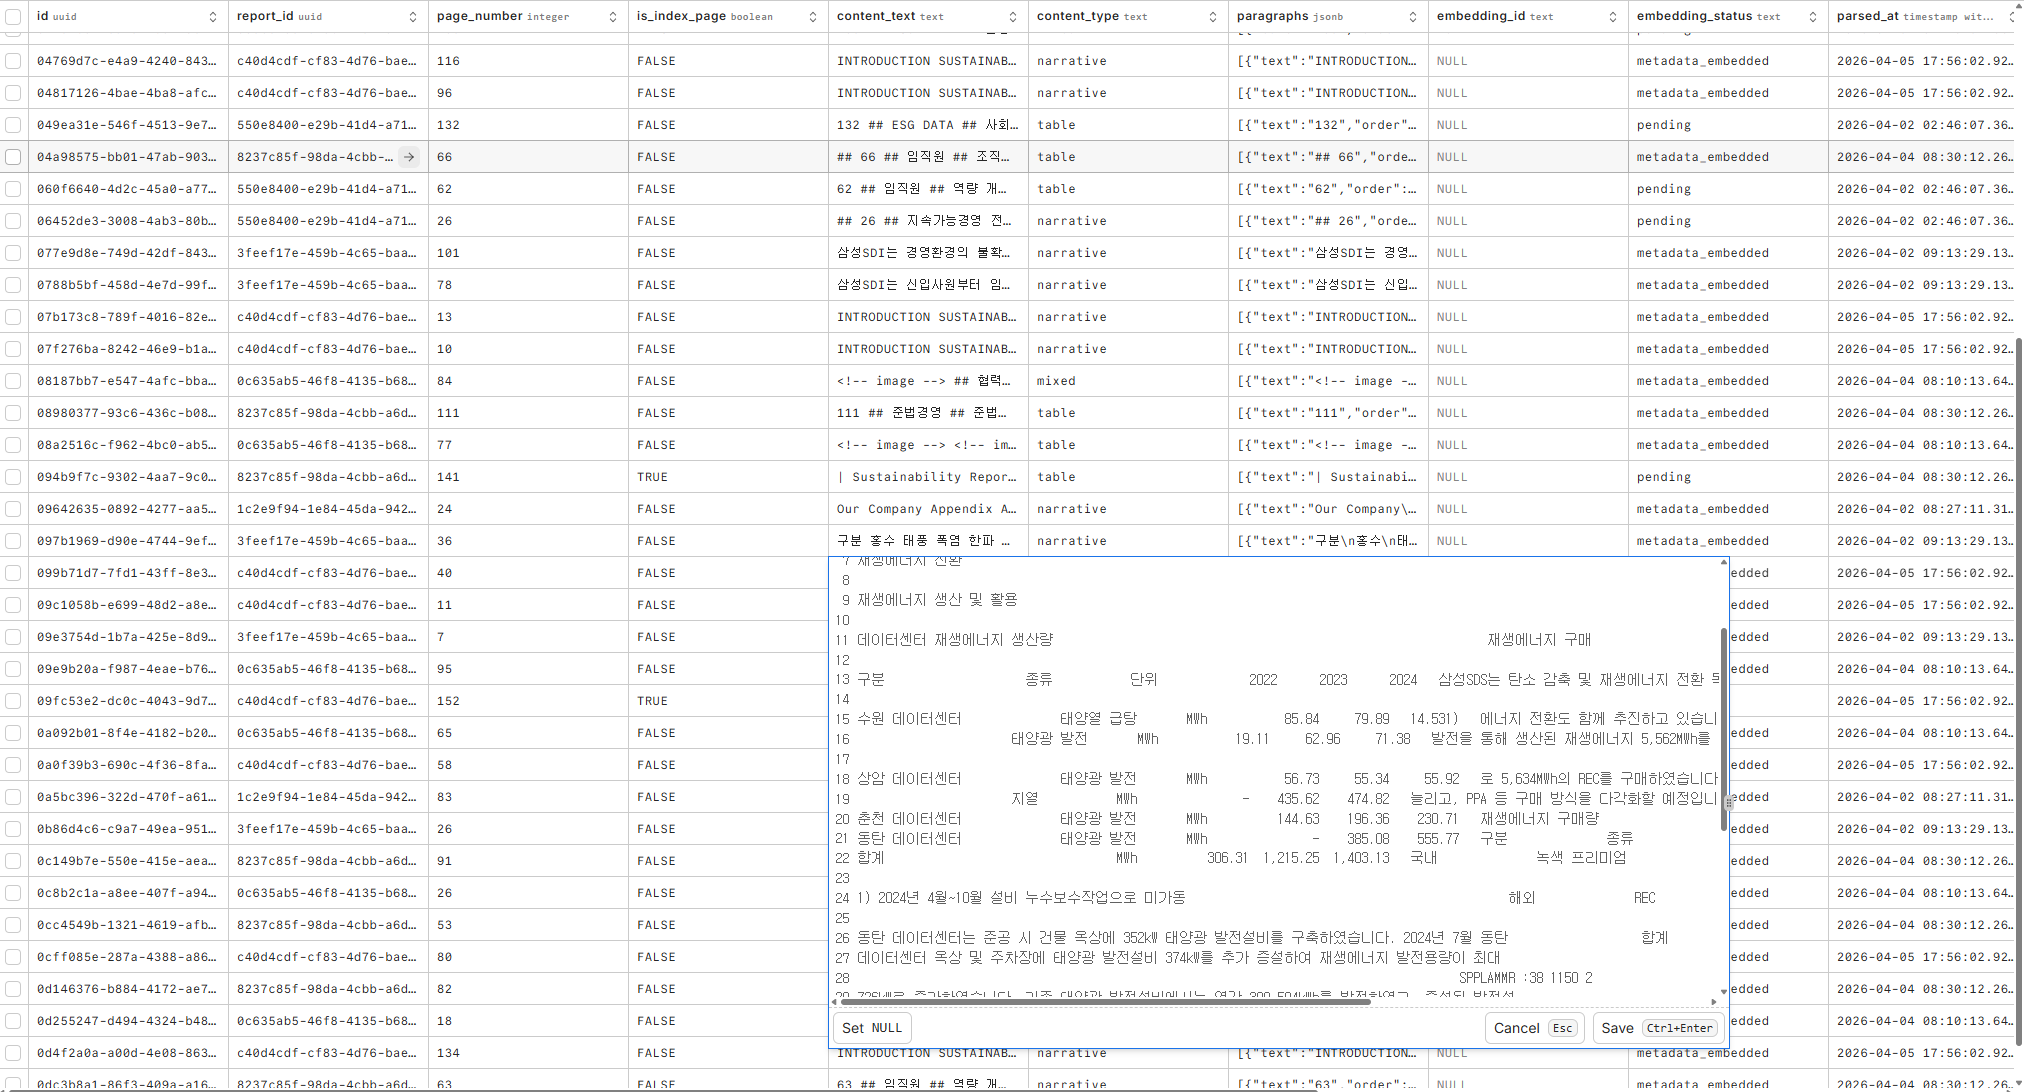
외부 SR 보고서 자동 수집
크론 스케줄러가 주기적으로 Tavily 웹 검색으로 기업 지속가능경영보고서 PDF를 찾아 내려받고, LangGraph 3-에이전트(목차·본문·이미지)가 파싱합니다. 본문은 512토큰 청크로 임베딩(bge-m3, 1024차원)되어 pgvector에 저장되고, RAG의 근거 데이터가 됩니다.
시스템 아키텍처
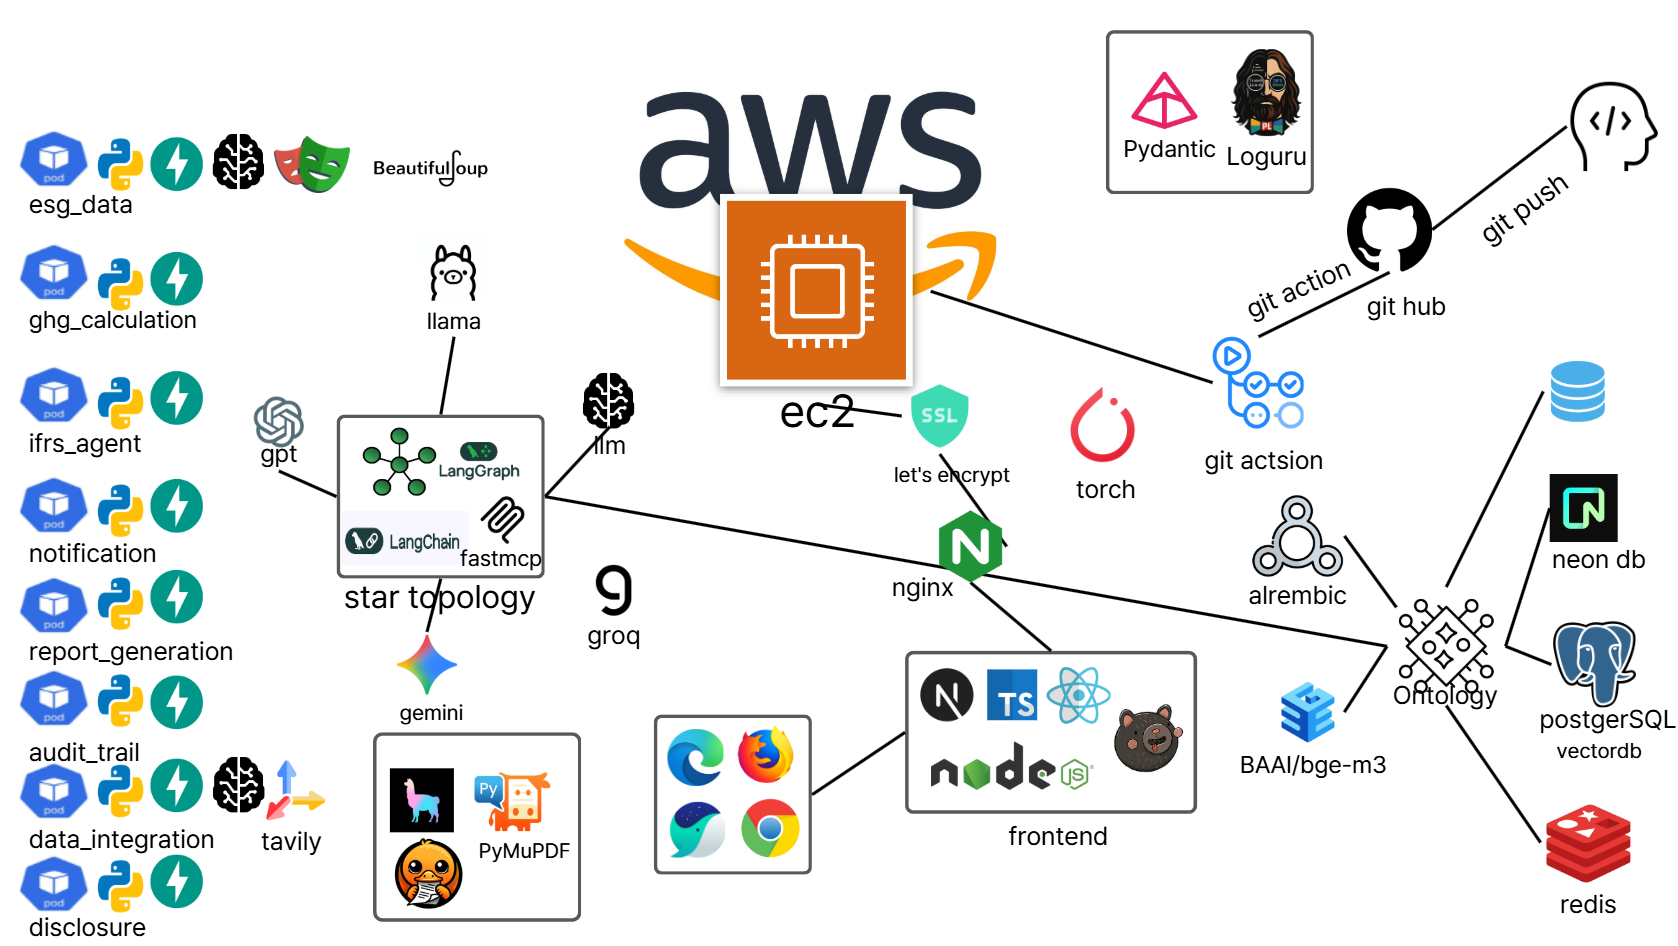
모놀리식 레이어드 아키텍처 위에 도메인별 Hub & Spokes 패턴을 적용했습니다.
Next.js 프론트엔드가 REST API로 FastAPI 백엔드와 통신하고, 백엔드는 API Layer(라우팅·검증) → Core Layer(설정·DB 연결 풀·미들웨어) → Domain Layer(비즈니스 로직)로 책임을 분리했습니다. 각 도메인(ifrs_agent, esg_data, ghg_calculation, data_integration)은 오케스트레이터 역할의 Hub와 에이전트·툴이 위치한 Spokes로 나뉘며, 저장소는 PostgreSQL + pgvector가 벡터 스토어를 겸합니다. 프로덕션은 AWS EC2 g4dn(T4 GPU) 위에서 ALB → Nginx → Uvicorn 구성으로 서비스 중입니다.
기술 스택
기술적 도전 & 해결
개발 과정에서 부딪힌 문제와 해결 방법입니다.
LangGraph 노드 간 상태 전달 시 타입 불일치와 직렬화 오류가 반복 발생
TypedDict + Pydantic으로 상태 스키마를 강제하고, 체크포인트(SQLite Saver)를 활용해 실패 지점부터 재개 가능하게 설계
10만 개 벡터 검색 시 3초 이상 소요되는 pgvector 성능 병목
IVFFlat 인덱스(lists=100) 적용과 병렬 쿼리로 평균 25ms 수준까지 단축
LLM이 존재하지 않는 수치를 지어내는 환각(Hallucination) 문제
RAG로 실제 DB 데이터만 컨텍스트에 주입하고, 생성 후 Validator Node가 규칙 기반 + LLM 정확도 검증을 이중 수행
단순 벡터 검색만으로는 의도가 다른 유사 문장을 구분하지 못함 (예: "배출량 증가" vs "배출량 감소 목표")
벡터 유사도 → 키워드 FTS 필터링 → LLM 컨텍스트 재선택의 3단계 하이브리드 RAG로 정확도 82% → 94% 개선
Gemini/GPT API 비용이 월 $2,400까지 증가
작업 난이도별 계층적 모델 선택(flash/pro), DP 메타데이터 캐싱, 40개 단위 배치 처리로 월 $850까지 65% 절감
성과
- API 응답 시간 p50 180ms / p95 850ms, 동시 요청 150 req/s (asyncpg 연결 풀)
- SR 보고서 생성 평균 45초 (Phase 0~4 전체), GHG 계산 1,000행 3초
- 테스트 커버리지 78% (Pytest), Backend 25,000 LOC · Frontend 15,000 LOC